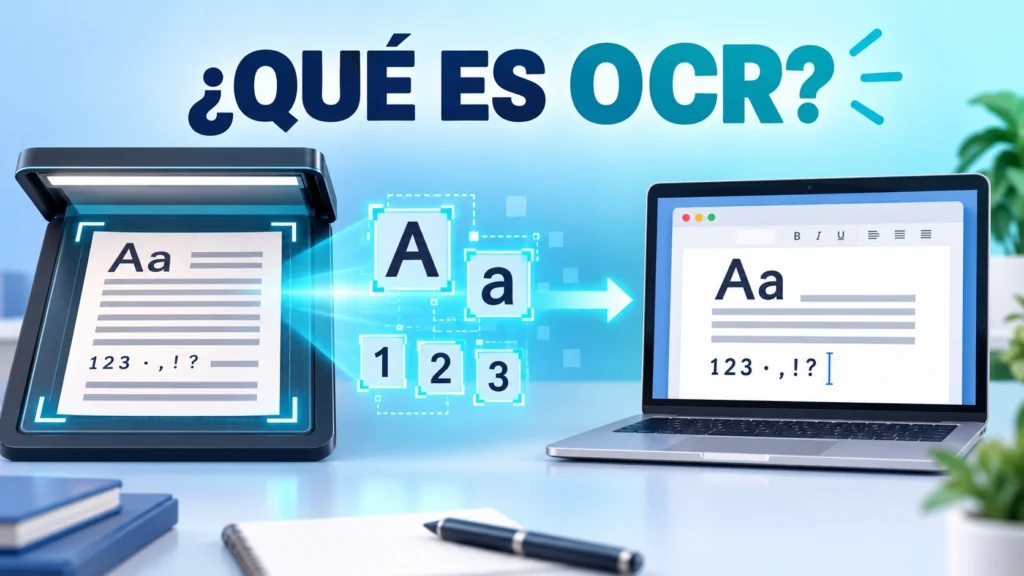
OCR es una tecnología que reconoce las letras y los números presentes en una imagen para convertirlos en texto editable. Gracias a este sistema, puedes recuperar el contenido de una fotografía, un documento escaneado o un PDF sin tener que escribirlo manualmente.
Por ejemplo, si fotografías una factura con tu teléfono, el archivo resultante solo contiene píxeles. Aunque tú puedes leer los datos, un editor de texto no puede modificarlos. El OCR analiza la imagen, identifica cada carácter y crea una versión que puedes copiar, buscar o editar.
¿Qué significa OCR?
OCR son las siglas en inglés de Optical Character Recognition, que en español significa reconocimiento óptico de caracteres. Su función es detectar texto dentro de archivos que originalmente no contienen información textual editable.
Esta tecnología puede reconocer diferentes elementos:
- Letras mayúsculas y minúsculas.
- Números, fechas y cantidades.
- Signos de puntuación y símbolos.
- Párrafos y encabezados.
- Columnas, tablas y bloques de contenido.
Un PDF creado directamente desde Word normalmente ya contiene texto seleccionable. En cambio, un PDF generado al escanear hojas suele guardar cada página como una imagen. En ese segundo caso necesitas aplicar OCR.
¿Cómo funciona el reconocimiento OCR?
El proceso parece inmediato, pero incluye varias etapas. Primero, el programa examina la imagen y trata de separar el contenido útil de elementos como sombras, fondos, manchas o bordes.
Después localiza las líneas, palabras y caracteres. Finalmente, compara sus formas con patrones aprendidos para determinar qué letra o número representa cada figura.
Preparación de la imagen
Antes de reconocer el texto, algunas herramientas corrigen la inclinación, aumentan el contraste y eliminan parte del ruido visual. Esta preparación es importante cuando el documento proviene de una fotografía tomada con el teléfono.
En nuestras pruebas, una página fotografiada de frente y con iluminación uniforme produjo resultados mucho más precisos que la misma página capturada desde un ángulo lateral.
Detección de caracteres
El sistema divide el contenido en zonas y analiza la forma de cada carácter. Los programas modernos utilizan modelos capaces de reconocer diferentes tipografías, tamaños y distribuciones.
Si detectan una secuencia parecida a “documento”, también pueden usar el contexto para evitar confundir una letra con otra. Sin embargo, el resultado no siempre es perfecto y conviene revisarlo.
Creación del texto editable
Una vez identificados los caracteres, la herramienta genera texto digital. Dependiendo del servicio utilizado, el resultado se puede copiar, descargar o exportar a formatos como TXT, Word o PDF con búsqueda.
¿Para qué sirve el OCR?
El reconocimiento óptico de caracteres resulta útil cuando necesitas aprovechar información que está encerrada dentro de una imagen.
Sus aplicaciones más habituales incluyen:
- Convertir apuntes escaneados en texto editable.
- Extraer datos de facturas, recibos y formularios.
- Digitalizar libros o documentos impresos.
- Buscar palabras dentro de un PDF escaneado.
- Copiar fragmentos de una captura de pantalla.
- Preparar archivos para su traducción o corrección.
- Hacer que ciertos documentos sean más accesibles.
También puede ahorrar bastante tiempo en trabajos administrativos. Si tienes que recuperar varias páginas impresas, aplicar OCR suele ser más eficiente que transcribir cada párrafo.
Cómo convertir una imagen en texto editable
El procedimiento exacto cambia según la herramienta, pero la mayoría de los servicios funcionan de manera parecida.
- Prepara el documento. Coloca la hoja sobre una superficie plana y asegúrate de que no tenga dobleces, sombras intensas ni objetos encima.
- Toma una fotografía clara. Mantén la cámara paralela al documento. Procura que toda la página aparezca dentro de la imagen y que las letras se vean enfocadas.
- Sube la imagen a una herramienta OCR. Normalmente se admiten archivos JPG, JPEG, PNG y, en algunos casos, documentos PDF.
- Selecciona el idioma correcto. Esta configuración ayuda a distinguir las tildes, la letra ñ y otras características propias del español.
- Inicia el reconocimiento. La herramienta examinará la imagen y mostrará el texto detectado después de unos segundos.
- Revisa el resultado. Comprueba especialmente los nombres, fechas, importes y números de identificación.
- Copia o descarga el texto. Guarda el contenido en el formato que necesites y conserva la imagen original por si tienes que verificar algún dato.
Cómo mejorar la precisión del OCR
La calidad del archivo original influye directamente en el resultado. Una herramienta avanzada puede cometer errores si recibe una imagen borrosa, oscura o demasiado comprimida.
Notamos que al usar una imagen con buena iluminación y texto oscuro sobre fondo claro disminuyen las confusiones entre caracteres parecidos, como el número “0” y la letra “O”.
Para obtener una conversión más precisa:
- Usa imágenes nítidas y con una resolución suficiente.
- Evita sombras sobre el texto.
- Endereza la página antes de procesarla.
- Recorta los bordes y objetos innecesarios.
- Selecciona el idioma del documento.
- Procesa una página a la vez si el archivo es complejo.
- Revisa manualmente la información importante.
Un error común que vemos a menudo es fotografiar el documento desde muy lejos y luego ampliar la imagen. Aunque las letras parezcan legibles en pantalla, pueden haber perdido detalles necesarios para que el OCR las identifique correctamente.
¿Qué documentos pueden causar errores?
El OCR suele funcionar mejor con documentos impresos y bien organizados. Puede tener más dificultades con textos escritos a mano, letras decorativas, páginas deterioradas o fondos con dibujos.
Las tablas también representan un reto. El sistema puede reconocer sus palabras y números, pero no siempre conserva correctamente las filas y columnas. En estos casos, conviene comprobar la estructura antes de utilizar los datos.
También debes prestar atención a:
- Sellos colocados encima de las palabras.
- Páginas curvadas cerca del lomo de un libro.
- Texto con poco contraste.
- Documentos fotografiados en perspectiva.
- Caracteres pequeños o parcialmente borrados.
OCR no es lo mismo que editar una imagen
Aplicar OCR no modifica necesariamente la imagen original. Su objetivo principal es detectar el contenido escrito y producir una capa de texto o un archivo nuevo.
En un PDF con OCR, la página puede conservar su apariencia de escaneo, pero permite seleccionar palabras y realizar búsquedas. En una exportación a Word, en cambio, el contenido puede quedar completamente editable, aunque el diseño original podría variar.
¿Es seguro utilizar una herramienta OCR?
La seguridad depende del servicio y del tipo de documento. Antes de subir un archivo, revisa si contiene contraseñas, información bancaria, firmas, datos médicos o documentos de identidad.
Para archivos sensibles, utiliza una solución que explique cómo procesa y elimina los documentos. Si solo necesitas practicar, comienza con una imagen que no incluya información privada.
Además, el OCR no confirma que el contenido reconocido sea correcto. Si vas a utilizar los datos en un trámite, contrato o cálculo, compáralos siempre con el documento original.
Convierte tus imágenes en texto sin transcribirlas
Ahora que sabes qué es OCR, puedes usarlo para recuperar información de fotografías, escaneos y archivos PDF. Una buena captura, el idioma correcto y una revisión final suelen ser suficientes para obtener un texto útil y fácil de editar.
Puedes aplicar estos pasos de forma gratuita y segura con las herramientas disponibles en SimpleiaTec.com. Empieza con un documento sin información confidencial, revisa el texto reconocido y descarga el resultado en el formato que necesites.